GitHubのトレンドで alibaba/open-code-review を見かけました。AIコードレビューのCLIです。
私が引っかかったのは、READMEの「Deterministic Engineering × Agent Hybrid」という設計思想のところでした。レビューの中で絶対に間違えてはいけない工程は、モデルではなくエンジニアリングのロジックで担保すると書いてある。対象ファイルの選定、関連ファイルのまとめ方、ルールの割り当て、そしてコメントの位置決めと再考。ここが決定的だから精度が出る、という主張です。
主張としては、かなり好きな部類です。テストは目的ではなく手段で、レビューも同じ。「AIがいい感じにやってくれる」では工程として設計できないので、どこが決まっていてどこが揺れるのかがはっきりしている方が現場では扱いやすい。
ただ、私の信条は「測れないものは改善できない」です。だから、書いてあることを読んで納得する代わりに、実際に何がLLMに飛んでいるのかを全部記録して確かめることにしました。
課金せずに中身を見る
このツールはレビューにLLMが要ります。無料枠のあるサービスのキーを入れて回してもよかったのですが、それだと「何が送られたか」がサービス側のログ頼みになる。
なので、コンテナの中にOpenAI互換のモックサーバを立てました。Node標準ライブラリだけの90行ほどのもので、/v1/chat/completions に来たリクエストを全部JSONで保存し、こちらが決めた応答を返すだけです。ocr 側はカスタムプロバイダとして http://127.0.0.1:9000/v1 を向けるだけで繋がります。
これで、送信バイト数もプロンプト本文もツール定義も、全部こちらの手元に残ります。課金もゼロです。
検証はいつもどおり使い捨てのDockerコンテナの中で、ホストには何も入れずにやりました。
# ---- 環境 ----
$ cat /etc/os-release | head -2
PRETTY_NAME="Debian GNU/Linux 12 (bookworm)"
NAME="Debian GNU/Linux"
$ node -v; npm -v; git --version
v22.23.1
10.9.8
git version 2.39.5

# ---- インストールは npm 一発 ----
$ time npm install -g @alibaba-group/open-code-review
added 2 packages in 2s
real    0m2.003s

$ ocr --version
open-code-review v1.12.9 (bccbc15) linux/amd64
built at: 2026-09-22T11:04:08Z

$ du -sh $(npm root -g)/@alibaba-group
57M     /usr/local/lib/node_modules/@alibaba-group

# ---- 以降、ocr を叩くたびに毎回これが出る ----
warning: git 2.39.5 is older than the minimum supported version 2.41.0; consider upgrading git
インストールは2秒、57MB。Goのバイナリをnpmで配っている形なので、ランタイムを別途入れる必要がありません。ちなみにビルド時刻が私が触った当日の午前でした。動きの速いリポジトリです。
最後の警告行は、READMEの前提条件に Git >= 2.41 とあるのに対して、Debian bookwormの標準gitが2.39.5だから出ています。今回の範囲では動作に支障は出ませんでした。ただ、CIのログにこれが毎行混ざるのは気持ちのいいものではないので、ベースイメージを選ぶときは頭に置いておくといいと思います。
まず、LLMを使わない部分だけを見る
このツールには ocr delegate という、LLM設定なしで動くモードがあります。ファイル選定とルール解決だけをやって、レビュー本体は呼び出し側のエージェントに任せるためのものです。
ここが「決定的」を名乗っている中心なので、最初にここを測りました。検証用に、Java・Python・JavaScript・Go・propertiesを混ぜた15ファイルのダミーリポジトリを作ってあります。SQLインジェクション、NPEになる呼び出し、同期していない静的キャッシュ、innerHTML への直挿しといった、いかにも指摘されそうな欠陥をわざと仕込んだものです。
# ---- ファイル選定(LLM不要) ----
$ time ocr delegate preview
# Files (10 reviewable / 15 total)

- mode: workspace
- total_insertions: 114
- total_deletions: 0

  - `app/db.py` [added] +13/-0
~~- `dist/bundle.js` [added] +1/-0 (excluded: default_path)~~
~~- `docs/CHANGELOG.md` [added] +5/-0 (excluded: unsupported_ext)~~
  - `i18n/messages_en.properties` [added] +3/-0
  - `i18n/messages_ja.properties` [added] +3/-0
  - `i18n/messages_zh.properties` [added] +2/-0
  - `internal/handler/handler.go` [added] +25/-0
~~- `package-lock.json` [added] +6/-0 (excluded: default_path)~~
  - `src/main/java/com/example/Order.java` [added] +9/-0
  - `src/main/java/com/example/OrderService.java` [added] +26/-0
  - `src/main/java/com/example/User.java` [added] +6/-0
  - `src/main/java/com/example/UserRepository.java` [added] +5/-0
~~- `test/order_service_test.py` [added] +2/-0 (excluded: default_path)~~
  - `web/render.js` [added] +7/-0
~~- `web/vendor/jquery.min.js` [added] +1/-0 (excluded: default_path)~~

real    0m0.033s

# ---- ルール解決(LLM不要)。拡張子ごとにグループ化される ----
$ ocr delegate rule <上の10ファイル> > /tmp/rule-all.txt
$ wc -c /tmp/rule-all.txt
26301 /tmp/rule-all.txt
$ grep -n "^### Rule Group" /tmp/rule-all.txt
1:### Rule Group 1: system / **/*.{py,pyi,ipynb}
88:### Rule Group 2: system / **/*.properties
110:### Rule Group 3: system / **/*.go
189:### Rule Group 4: system / **/*.java
243:### Rule Group 5: system / **/*.{ts,js,tsx,jsx,mjs,cjs}
33ミリ秒です。除外理由が default_path / unsupported_ext と機械可読な形で付いていて、除外されたものは取り消し線で残る。ここは確かに決定的で、しかもなぜ外れたかが読めるのがいい。レビュー対象の選定が読めないままだと、「なぜこのファイルを見てくれないのか」を追う手段がなくなります。
気づいた点がひとつ。test/ ディレクトリは既定で除外です。テストコードをレビュー対象にしたい現場は少なくないと思うので、ここは設定を確認してから導入した方がいいところです。
ルールの中身も想像より具体的でした。26,301バイトの正体は、Pythonなら「ミュータブルなデフォルト引数」「except: の裸catch」「is で文字列比較」、propertiesなら「キーの重複定義」「Unicodeエスケープの不備」といった粒度のチェックリストで、拡張子ごとに書き分けられています。冒頭には Favor precision over recall と明記されていて、精度優先の方針がチェックリスト自体に埋まっている。
なお ocr rules check <path> というコマンドもあるのですが、これは除外フィルタを通さず「もし対象だったらどのルールが当たるか」を答えます。dist/bundle.js に対しても平然とJSのルールを出してきました。「なぜこのファイルがレビューされないのか」を調べたいときは delegate preview の方を見る必要があります。ここは一度ハマりました。
「決定的」と書いてあったまとめ方は、LLMだった
ここからが本題です。モックを繋いで ocr review を通し、飛んできたリクエストを順に開きました。
1本目のリクエストのsystemプロンプトが、これでした。
You are a file grouping assistant for code review. Group changed files into semantically related clusters that should be reviewed together.
Files in the same group typically:
- Belong to the same module/feature
- Have producer/consumer relationships (e.g. interface and implementation)
- Are i18n/config variants of the same resource (e.g. message_en.properties and message_zh.properties)
READMEが「決定的エンジニアリング」の例として挙げていた smart file bundling ――message_en.properties と message_zh.properties を同じレビュー単位にまとめるやつ――は、LLMへの問い合わせでした。systemが905文字、userが698文字の、独立した1リクエストです。
ビューアでもそのまま見えます。File Groupingというパネルが「1 request」と数えられていて、中身は GROUPING_TASK の Request #1。
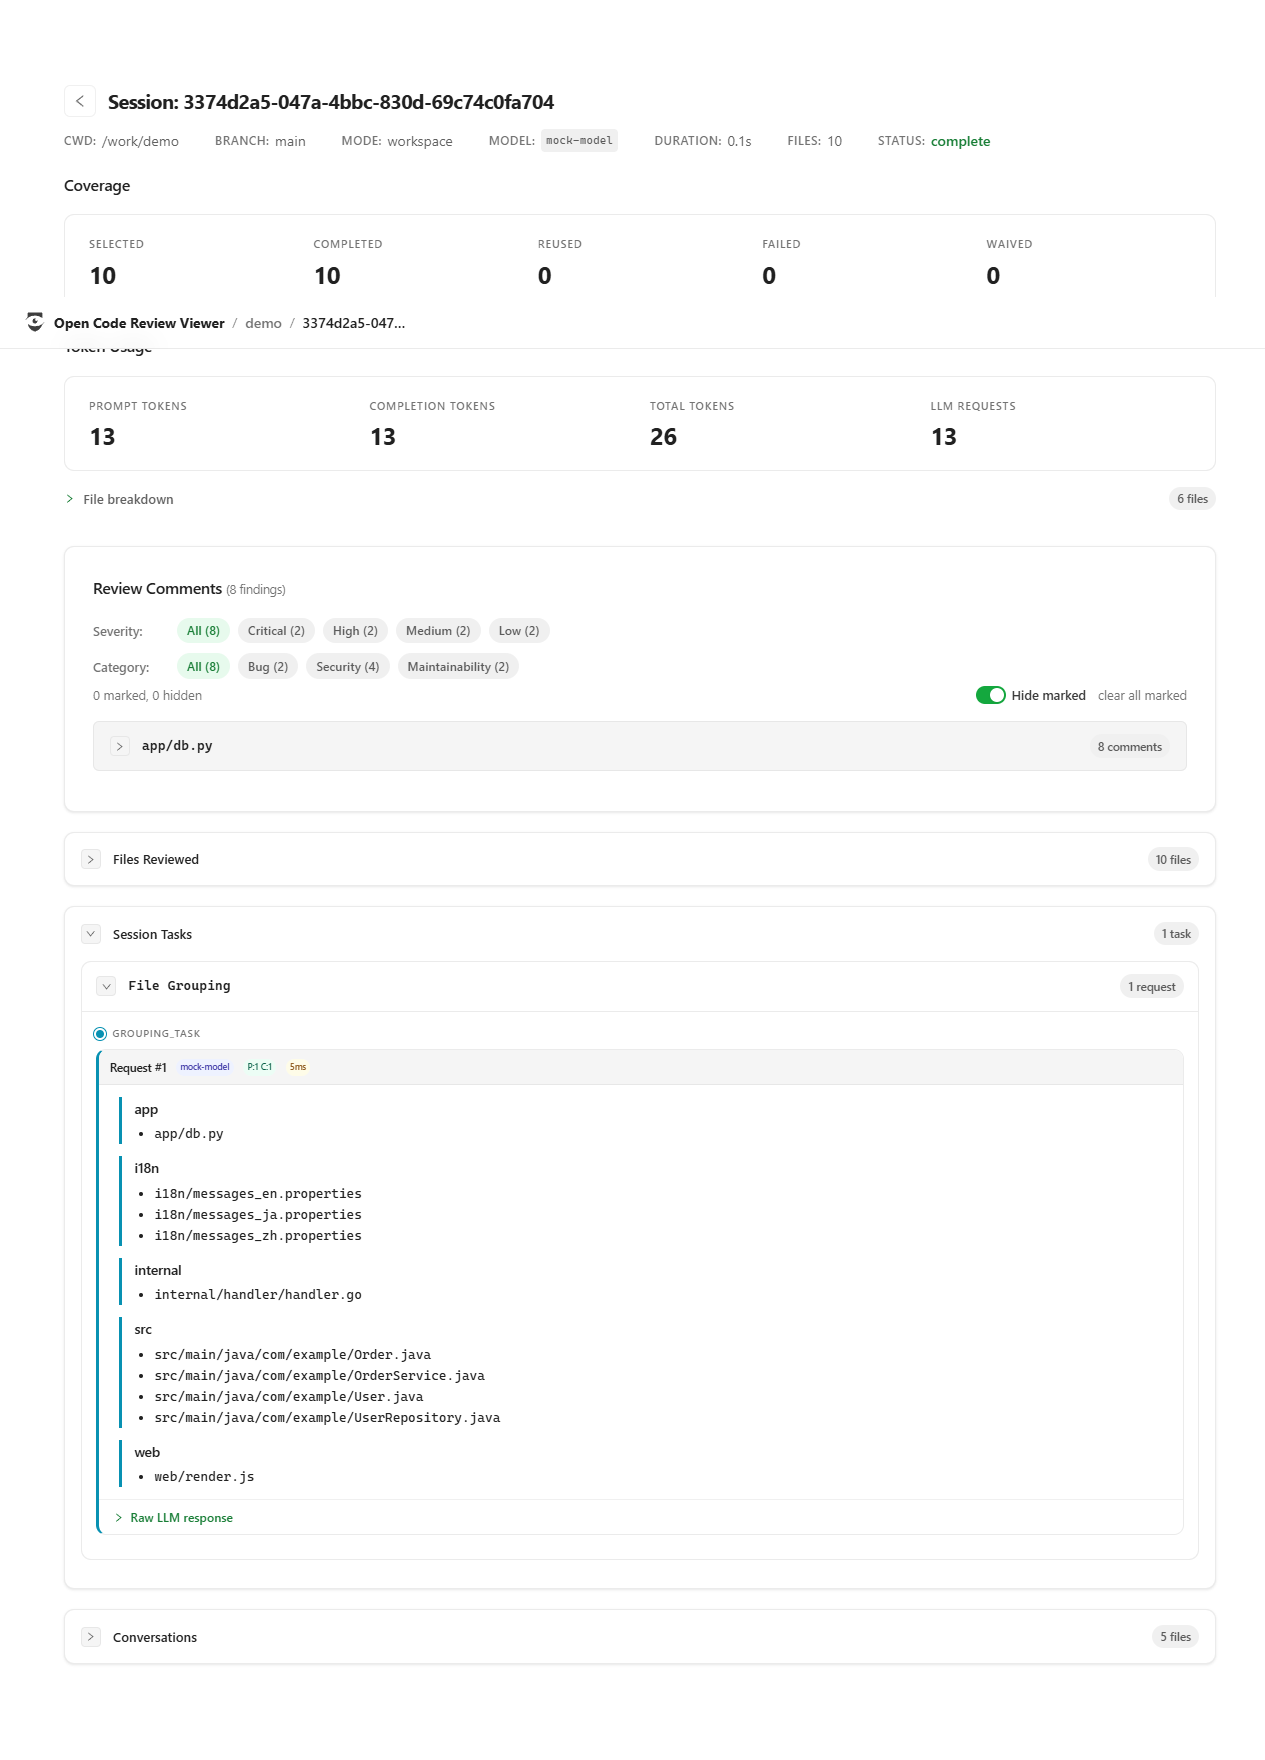
誤解のないように書いておくと、これは「嘘だった」という話ではないと思っています。ファイル選定もルール解決も本当にコード側で決まっていたし、まとめ方だけをモデルに委ねるのは設計として理解できる。分類は意味の問題なので、拡張子やディレクトリのルールで書き切るのは確かにしんどい。
ただ、READMEの分類をそのまま信じるとこの1リクエストが見えません。LLMが落ちているとき、あるいは応答がJSONとして壊れているときに何が起きるかは、知っておく必要があります。試しにモックからJSONではない文字列を返したところ、フォールバックは「1ファイル1グループ」でした。エラーにはならず、静かに粒度が変わります。
これは無視できる差ではありませんでした。同じ差分で、グループ分けだけを変えて2回流した結果がこれです。
| グループ分け | レビュー単位 | LLMリクエスト数 | 送信バイト数 |
|---|---|---|---|
| ディレクトリ単位にまとめた場合 | 5 | 6 | 89,310 |
| 1ファイル1グループ(フォールバック相当) | 10 | 11 | 157,940 |
同じ10ファイル・114行の追加に対して、送信量が43%変わりました。
理由ははっきりしています。レビュー本体のプロンプトは、グループごとにsystemプロンプトと、そのファイル種別のルール全文と、「このグループ外で変更された他のファイル一覧」を毎回繰り返す構造です。3行のpropertiesファイル1枚をレビューさせるだけで、systemが2,571文字、userが1,738文字。固定費がグループ数だけ掛かるので、まとめ方がそのままコストになります。
READMEのベンチマークにある「トークンが約1/9」という主張の下側で効いているのは、たぶんこのあたりです。実際、モデルに渡していたツールは task_done / code_comment / code_search / file_read / file_read_diff / file_find の6個だけでした。汎用のコーディングエージェントを持ってくると、ツール定義だけで数万バイトになります。用途を絞った6個なら、その分が丸ごと浮く。ここは納得のいく設計でした。
コメントの位置決めは、どこまで耐えるのか
もうひとつ確かめたかったのが、位置決めです。
READMEは「Position drift ―― 指摘の行番号がずれる」を汎用エージェントの弱点として挙げ、独立した位置決めモジュールで解決していると書いています。実際、code_comment ツールの説明にはこうありました。
This tool uses a dynamic sliding window algorithm to match corresponding consecutive lines in diff text based on your provided ‘existing_code’ parameter.
モデルが「このコードについての指摘です」とスニペットを渡すと、それを差分の中から探して行に貼る。ということは、渡すスニペットの形が崩れたときにどうなるかが品質の分かれ目になります。
ここはテスト設計と同じ考え方でケースを切りました。モックから6件のコメントを一度に返し、existing_code の与え方だけを1要素ずつ変えています。
| ケース | 渡したスニペット | 結果 |
|---|---|---|
| A | 追加行と完全一致 | L6 に正しく着地 |
| B | 先頭に差分の + を付けたまま | L12 に正しく着地 |
| C | インデントを全部削った | L5 に正しく着地 |
| D | 連続する2行 | L7-L8 の範囲として着地 |
| E | ファイルに存在しない行 | 追加のLLM呼び出しで再解決を試みる。失敗すると行0のまま残る |
| F | レビュー対象外のファイルのコード | 受理され、そのファイルのL2に着地 |
A〜Dは素直に強かったです。特にBとCが通るのはありがたい。モデルが差分の + を消し忘れたり、インデントを勝手に整えたりするのは日常的に起きるので、そこを吸収できているのは実装としてまともです。ビューアで見ると、+ が付いたまま渡したケースBもちゃんとL12に貼られていました。
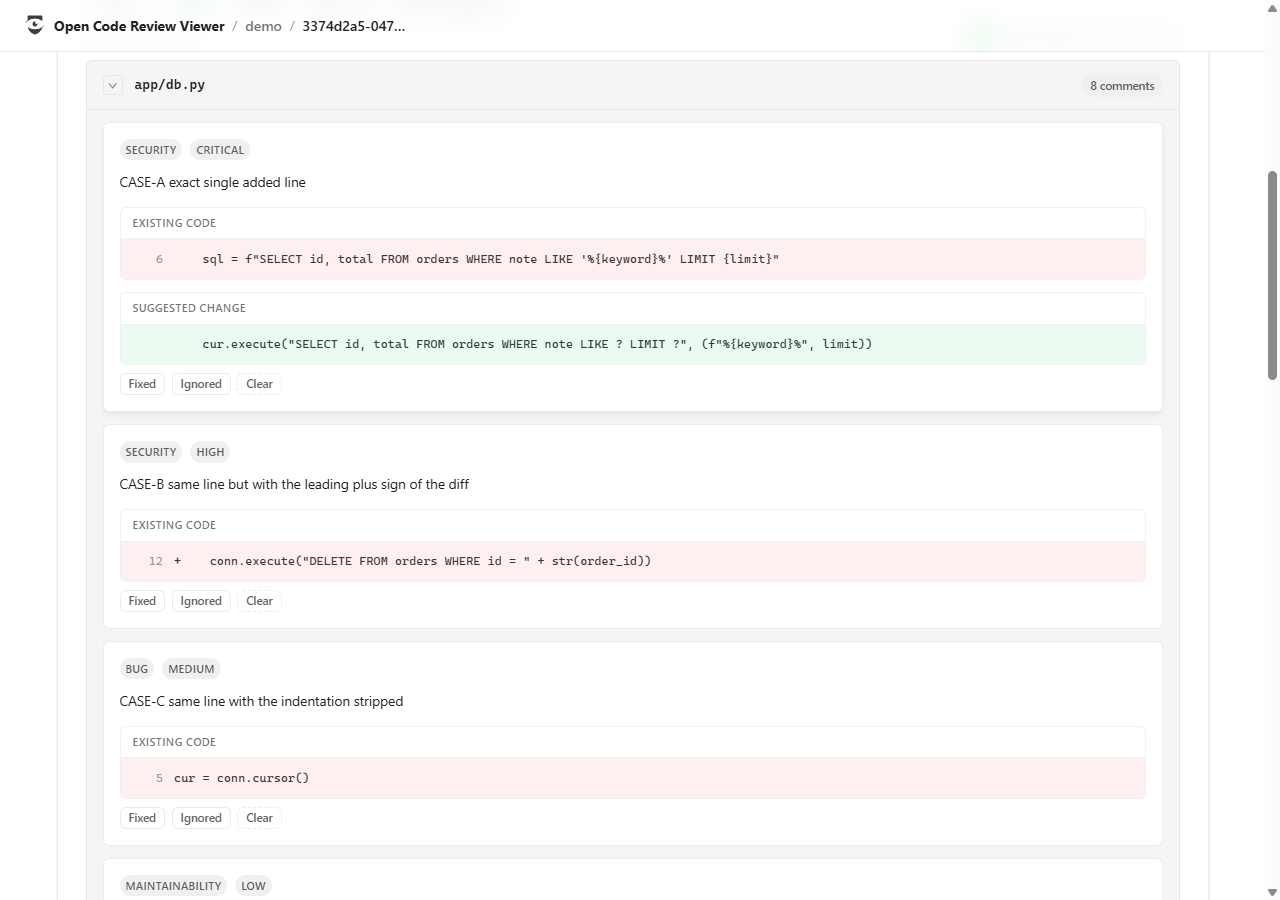
面白かったのはEです。存在しないスニペットを渡すと、そこで捨てるのではなく、もう1回LLMを呼びます。You are a code location assistant. というsystemプロンプトで、差分と指摘文を渡して「この指摘が指している範囲を差分から抜き出せ」とやり直させる。最初にモックが応答を返せなかったときは start_line: 0, end_line: 0 のまま出力に残りました。
Fは想定外でした。レビュー本体のsystemプロンプトには never produce comments targeting files outside it(グループ外のファイルを指す指摘を作るな)と明記されています。それでもコメントは受理され、位置まで解決されて出力に載りました。
しかも、この後に走る検証フェーズにも渡りませんでした。
出力の数え方が2つあった
Eを捨てるのは、位置決めではなく別の工程でした。レビューの後に「fact-checker」という役のLLM呼び出しがもう1本あります。プロンプトの設計思想がはっきり書かれていて、ここは読む価値がありました。
- Keeping an incorrect comment costs a reviewer a few seconds of attention.
- Removing a correct comment silently destroys a real finding. It never reaches anyone, and nobody learns that it was dropped.
誤検知を残すコストと、正しい指摘を消すコストを非対称に扱い、迷ったら承認しろと指示している。ツールも report_incorrect_comments と approve_all_comments の2つしかありません。実際にこちらから「ケースEを消せ」と返したら Review filter removed 1 comment(s) for group "app/db.py" と出て、きれいに落ちました。
問題は、このfact-checkerに渡された候補が5件だったことです。ケースFは含まれていませんでした。グループの対象ファイルを基準に候補を集めているので、対象外のパスを名乗る指摘は検証工程を素通りします。
そして最終的な数え方がずれました。
# ---- ocr review --format json --output が書いた JSON の comments ----
   1  app/db.py     L6-6   CASE-A exact single added line
   2  app/db.py     L12-12 CASE-B same line but with the leading plus sign of the diff
   3  app/db.py     L5-5   CASE-C same line with the indentation stripped
   4  app/db.py     L7-8   CASE-D two consecutive added lines
   5  web/render.js L2-2   CASE-F snippet from a file outside this review group
   6  app/db.py     L6-6   CASE-A exact single added line     <- 6〜10 は 1〜5 とまったく同じ
  ...                                                            summary.comments も 10

# ---- 同じ実行のセッション記録(ビューアが読む側) ----
$ ocr session list
SESSION ID                            MODE       RANGE  FILES  COMMENTS  STATUS    STARTED
3374d2a5-047a-4bbc-830d-69c74c0fa704  workspace  -      10     8         complete  2026-09-22 12:12:20

# ---- 2ラウンド目のプロンプトに入っていた重複防止 ----
### Previously Confirmed Findings
The following issues were already identified and confirmed in a prior review pass.
Do not repeat them. Continue reviewing all files in <review_files> and report any other real issues you find.

<confirmed_findings>
1. app/db.py
   code: sql = f"SELECT id, total FROM orders WHERE note LIKE '%{keyword}%' LIMIT {limit}"
   issue: CASE-A exact single added line
...
JSONには10件、セッションには8件。差の2件は、ケースFのコメント(2ラウンド分)です。出力ファイルには残るのに、ビューアとセッション記録には現れません。
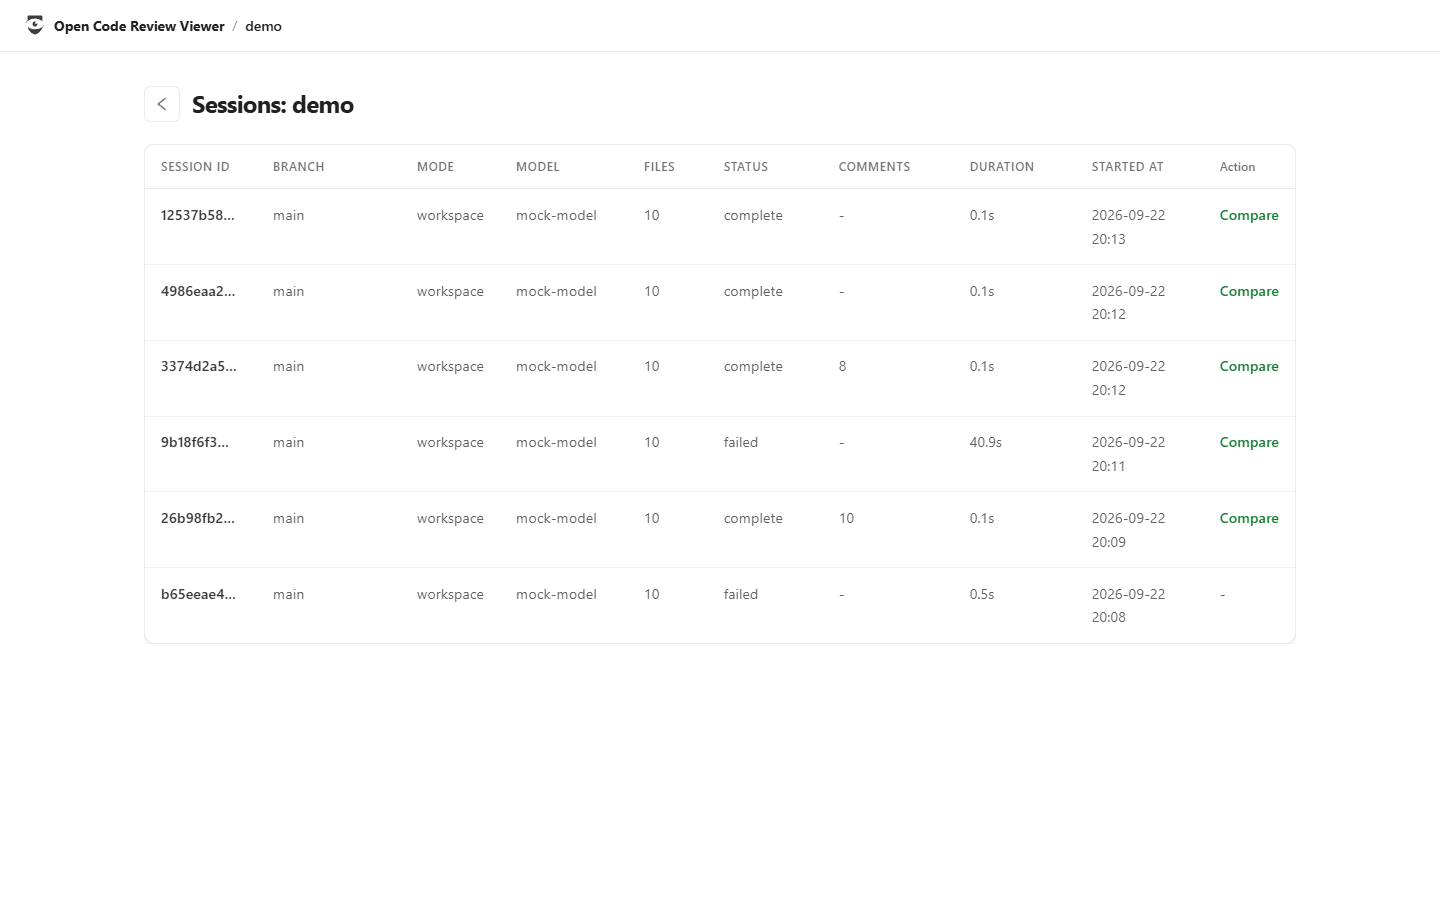
CIの結果をJSONで受けて、人はビューアで確認する、という使い方をすると、件数が一致しないことになります。実運用でレビュー対象外のパスを名乗る指摘がどれくらい出るのかは、私は測っていません。ただ、出力の系統が2つあって数が揃わないことがある、というのは受け入れ基準を書くときに押さえておく点だと思います。
同じ一覧の中に見える通り、5件が2回ずつ載っているのも気になるところです。これはレビューが2ラウンド回る仕様で、ひとつ前のコードブロックの最後にある通り、2ラウンド目のプロンプトには「すでに確認済みなので繰り返すな」という指示と確認済みリストが入ります。
重複防止は入っています。ただしプロンプトで頼んでいるだけで、コード側の突き合わせはありません。私のモックは指示を無視して同じ5件を返したので、そのまま10件になりました。本物のモデルなら普通は従うはずですが、「従わなかったとき何も起きない」のは事実として残ります。
ここは好みが分かれるところですが、私は決定的にできる範囲だと思いました。パスと行番号と本文が一致しているものを落とすだけなら、モデルに頼む必要はないはずです。
ツールを呼べないモデルを繋ぐと、静かに1000回叩く
最後にひとつ、事故の記録を。
最初のモックは、素朴に "OK" という文字列を返すだけのものでした。ツール呼び出しを返さないモデル、という想定です。小さなローカルモデルを繋いだときに起きうる状況でもあります。
$ ocr review
[ocr] No tool calls parsed for web/render.js, retrying...
[ocr] No tool calls parsed for src/main/java/com/example/UserRepository.java, retrying...
(延々と続く)
[ocr] Max tool requests reached for web/render.js.
[ocr] Subtask error for group "web/render.js": main_task did not complete before stopping (round 1/2)
Error: review failed: all 10 file review(s) failed — check your LLM configuration and API key

# ---- モック側に残った受信記録 ----
$ awk -F'\t' '{s+=$4; n++} END {print n" requests, "s" bytes"}' /tmp/llmlog/index.log
1012 requests, 23398500 bytes

# ---- そのときのセッションログ(左がバイト数。6件のうち2件を抜粋) ----
$ ls -l ~/.opencodereview/sessions/work-demo/ | awk '{print $5, $9}'
140176 3374d2a5-047a-4bbc-830d-69c74c0fa704.jsonl     <- 正常に終わった回
16290102 b65eeae4-da91-4415-b837-ea8e00aba469.jsonl   <- ツールを呼べなかった回
10ファイル・114行の差分に対して、1,011回のチャットリクエストと23.4MBの送信(先頭の1件はモデル一覧の取得です)。最後にはちゃんと止まりますし、エラーメッセージも「LLM設定とAPIキーを確認しろ」と正しいことを言っています。ただ、止まるまでに課金が走る先だったら、と考えると背筋が伸びました。
セッションログも16.29MBになりました。このログ、全リクエストとレスポンスを丸ごとJSONLで残す作りなので、差分の本文もプロンプトも全部ディスクに書かれます。正常に終わった回でも140,176バイトありました。ビューアで過去のレビューを再生できるのはこのおかげなので機能としては嬉しいのですが、保存先は ~/.opencodereview/sessions/ で、削除や保持期間の面倒は自分で見る必要があります。社外秘のコードを扱うなら、ここは導入前に確認する項目です。
なお、ocr が報告するトークン数はプロバイダが返した usage をそのまま表示します。私のモックは1リクエストあたり1トークンと嘘をついていたので、ビューアには TOTAL TOKENS 26 と出ていました。トークン数を判断材料にするなら、プロバイダ側の数字と突き合わせた方が安全です。
試してみての所感
動いた、という意味では最初から動きました。npmで2秒、設定はプロバイダとモデルの2行。差分を置いて ocr review で終わりです。ここは素直に良くできています。
ただ、動いた=品質OK ではない、というのが今回いちばん確かめたかったことでした。測ってみて分かった線引きは、こうです。
- ファイル選定とルール解決は本当に決定的で、除外理由まで読める
- まとめ方はLLMで、失敗すると静かに1ファイル1グループに落ちる(今回の差分では送信量が43%変わった)
- 位置決めは差分の記号やインデントの崩れに強く、外れたら別のLLM呼び出しで拾い直す
- 一方で、対象外ファイルを名乗る指摘と、ラウンド間の重複は、プロンプトで頼んでいるだけ
READMEの分類より、決定的な部分は少し狭い。でも、狭いなりにどこが狭いかを実測できたので、私としては導入の判断はしやすくなりました。
自分が受け入れ基準を書くとしたら、こう置きます。出力はJSONを正とし、ビューアの件数と一致しない可能性を前提にする。CIに入れる前に、ツール呼び出しを返せるモデルであることを小さな差分1本で確認する。セッションログの保持期間を決めてから本番のリポジトリに向ける。test/ を見るかどうかを先に決める。このあたりを最初に潰しておけば、あとは素直に働いてくれそうです。
次に試すなら ocr scan(差分なしで全ファイルを見るモード)と、複数ファイルをまたいだ指摘がどこまで出るかですね。今回は自分で作った小さなダミーリポジトリでしたが、本物の差分を通すとまた違う顔が見えると思います。