GitHubのトレンドに open-webui/open-webui が上がっていました。スターは154,419、今日増えた分は142。2026-10-10(UTC)に v0.12.0 が出たばかりです。
ここ最近、「社内向けに生成AIのチャット窓口を立てたい」という相談をよく受けます。候補に必ず名前が挙がるのがOpen WebUIなのですが、私は見積もりの前に一つ知っておきたいことがありました。利用者が1通送ったとき、裏でLLMに何本、どれだけの量の要求が飛ぶのか。従量課金のAPIにつなぐなら、ここがそのまま月々の費用になります。
そこで、本物のLLMの代わりに「届いた要求をすべて保存するだけのモック」をつないで、1通送って数えてみました。
試した環境
- 使い捨てのDockerコンテナ(
python:3.12-bookworm、Debian 12.14、Python 3.12.13)。メモリ4GB・CPU 2コアに制限し、終わったら破棄 - Open WebUI 0.12.0(PyPIの
open-webui==0.12.0、main は f8ae8a6c32) - 入れ方はREADMEの「Installation via Python pip」どおり、
pip install open-webui→open-webui serve - LLMは、コンテナの中に置いた自作のOpenAI互換モック(Python標準ライブラリだけ)。受け取った要求をファイルに保存し、決まった文を返します。
OPENAI_API_BASE_URLでここに向けたので、APIキーも課金もありません - 画面の操作と撮影は、コンテナの中のヘッドレスChromium(Playwright)で行いました
READMEは「Python 3.11を使うように」と書いていますが、PyPIのパッケージは >=3.11, <3.13 を受け付けます。今回は3.12で通しましたが、起動から会話まで特に困ることはありませんでした。
利用統計の3つの環境変数(SCARF_NO_ANALYTICS / DO_NOT_TRACK / ANONYMIZED_TELEMETRY)は、公式のDockerfileと同じ値にそろえています。Dockerfileでは最初から設定されているのに、pipで入れたときは自分で設定しない限り何も設定されていないからです。
pip一発で7.6GB。CPUしかないのにCUDAが付いてきた
最初の山場はインストールでした。コマンドは1行で、待ち時間も2分少々です。ただ、入ったものの量が想像と違いました。
$ pip install --progress-bar off open-webui==0.12.0
(rc=0、133.9秒、262パッケージ)

# site-packages の大きさ(バイト)
インストール前:      7,999,633
インストール後:  7,606,491,916

# 大きい順(du -sm、MB)
3196  nvidia
1177  torch
 897  triton
 249  open_webui
 139  pyarrow
 109  scipy

$ python -c "import torch; print(torch.__version__, torch.cuda.is_available())"
2.14.1+cu130 False

# ここは自分の使い方次第。GPUの無いマシンでも、既定ではCUDA 13向けの torch と nvidia-* が入る
7.6GBのうち、nvidia・torch・tritonの3つで5,269MB、全体の7割近くになります。Open WebUI本体は249MBです。GPUの無いコンテナなので torch.cuda.is_available() は False で、5GB余りを抱えたまま一度も使わないことになります。コンテナの受信量も、pipが終わった時点で3.77GBでした。
公式のDockerfileを読むと、GPUを使わない版では pip3 install 'torch<=2.9.1' ... --index-url https://download.pytorch.org/whl/cpu を先に実行してから、残りの依存を入れています。pipで入れる場合も同じ順番にすれば軽くなるはずですが、今回はそちらを測っていません。
正直なところ、ここは「教科書どおりにやって重すぎた」典型だと思いました。READMEの手順は間違っていません。ただ、検証用の小さなVMに入れる前提で見積もると、ディスクで足が出ます。
初回起動は33.7秒。その間にHugging Faceから889MB
open-webui serve は既定で 0.0.0.0:8080 で待ち受けます。起動を指示してから、ホストのブラウザ側でHTTP 200が返るまで33.7秒でした。ログを見ると、その時間の大半はデータベースの準備と、埋め込みモデルの取得に使われていました。
$ open-webui serve
INFO  [alembic.runtime.migration] Running upgrade ... (データベースの更新が続く)
| INFO | open_webui.models.config:seed_defaults:272 - Seeded 368 new config defaults
| INFO | httpx ... GET https://huggingface.co/api/models/sentence-transformers/all-MiniLM-L6-v2/revision/main "HTTP/1.1 200 OK"
Fetching 30 files:   0%|          | 0/30
| INFO | uvicorn ... "GET / HTTP/1.1" 200

# 取得した埋め込みモデルのキャッシュ: 889MB(同じモデルが形式違いで並ぶ)
91,005,696  tf_model.h5
90,888,945  pytorch_model.bin
90,887,379  rust_model.ot
90,868,376  model.safetensors
90,405,214  model.onnx (ほか onnx の最適化版・量子化版、openvino 版)

# データベースの置き場所
$ find / -name webui.db
/usr/local/lib/python3.12/site-packages/open_webui/data/webui.db
埋め込みモデルの all-MiniLM-L6-v2 は、30ファイルをまとめて取りに行っていました。TensorFlow用・PyTorch用・Rust用・ONNXの各種と、同じモデルが10種類近くの形式で並んでいます。使うのはこのうち1つのはずですが、どれを読んでいるかまでは確かめていません。
もう一つ気になったのが webui.db の場所です。pipで入れると、会話やユーザーを入れたデータベースが site-packages の中にできます。同じ場所の readme.txt には docker dir for backend files (db, documents, etc.) とだけありました。Dockerならボリュームに逃がす前提の場所なので、pipで本番運用するなら、DATA_DIR を自分で外に向けておかないと、入れ直しのときに危ないなと感じています。
初めて開くと、名前・メールアドレス・パスワードの3つだけの画面が出ます。最初に作ったアカウントがそのまま管理者になります。
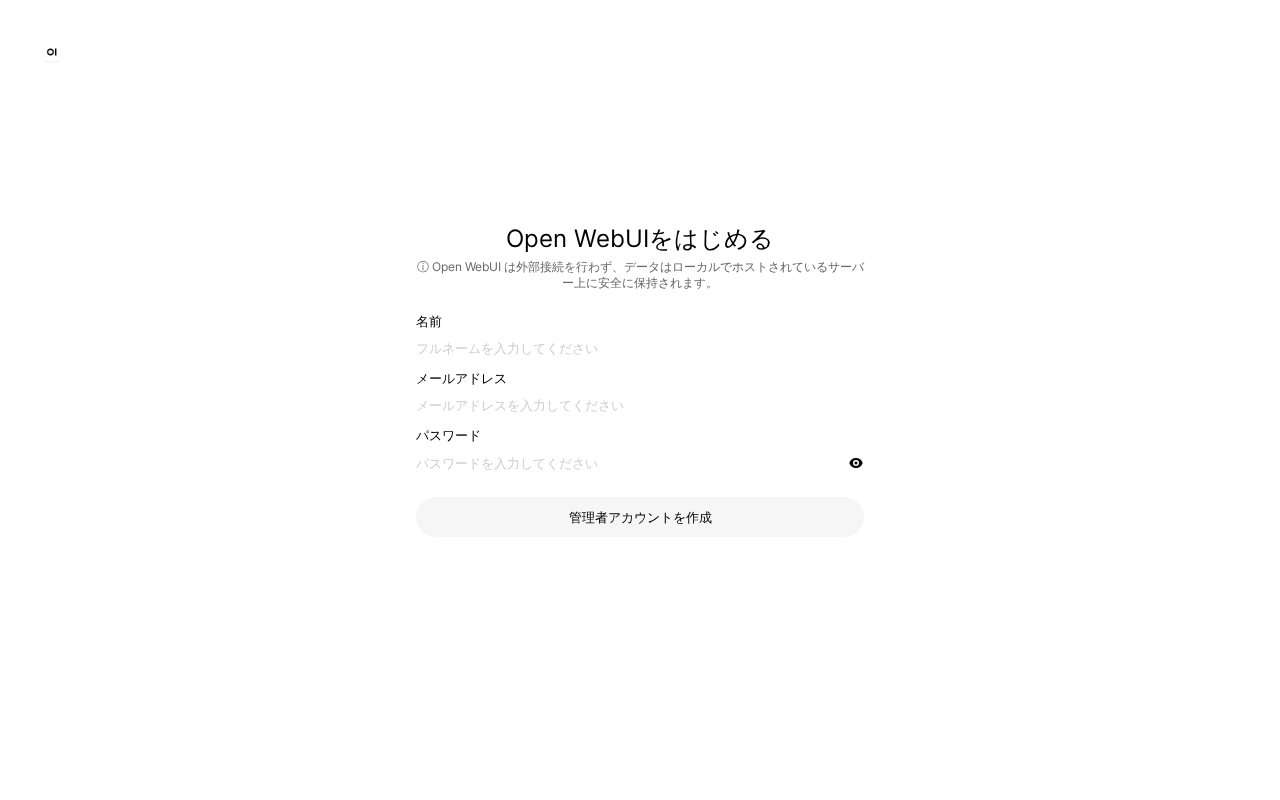
画面には「外部接続を行わず」と書かれています。会話のデータを外に送るわけではない、という意味だと読みましたが、ひとつ前のログのとおり、起動の時点でモデルの取得にはしっかり外へ出ています。閉じたネットワークで使う予定なら、モデルを先に置いておく段取りが要りそうです。
1通送ると、モックには4本届いた
ログインすると、モックの mock-model が最初から選ばれていました。ここで「コンテナの中からこんにちは。Open WebUI を初めて触っています。」と1通送ります。
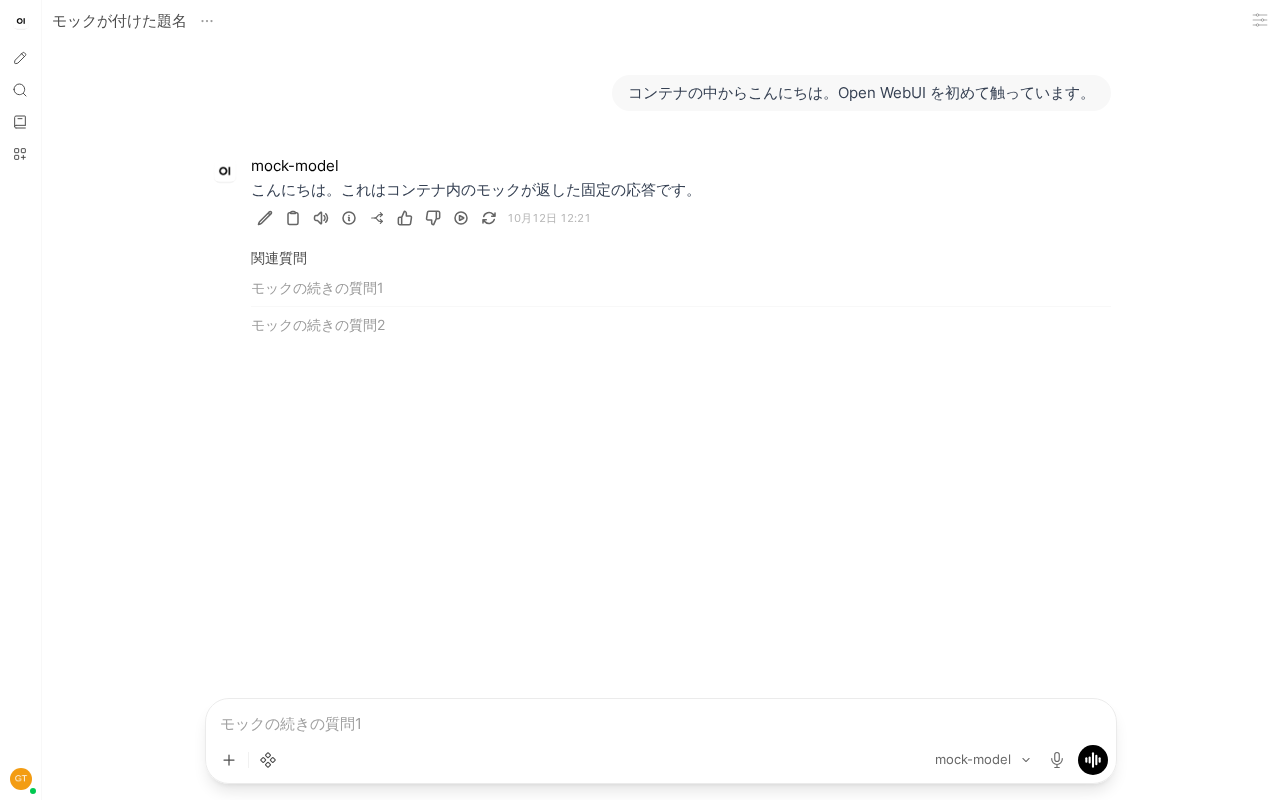
左上の題名と、下の「関連質問」も、モックが返した文がそのまま入っています。つまり、画面に見えている部品の分だけ、LLMが呼ばれていたわけです。モック側の記録はこうでした(POSTだけ抜き出し、時刻は秒の小数部のみ)。
.796 POST /v1/chat/completions n=1 task=title      stream=False bytes=1255  last='### Task:\nGenerate a concise title summarizing the chat hist'
.859 POST /v1/chat/completions n=2 task=chat       stream=True  bytes=26174 last='コンテナの中からこんにちは。Open WebUI を初めて触っています。'
.100 POST /v1/chat/completions n=3 task=follow_ups stream=False bytes=1258  last='### Task:\nSuggest 3-5 relevant follow-up questions or prompt'
.112 POST /v1/chat/completions n=4 task=tags stream=False bytes=1004 last='### Task:\nGenerate 1-3 broad tags categorizing the main them'| 順 | 用途 | 要求の大きさ | いつ送られたか |
|---|---|---|---|
| 1 | 題名を付ける | 1,255バイト(max_tokens 1000) | 本体より63ミリ秒先 |
| 2 | 本体(応答を流す) | 26,174バイト | 送信直後 |
| 3 | 続きの質問を作る | 1,258バイト | 応答が流れ終わった直後 |
| 4 | タグを付ける | 1,004バイト | 3の12ミリ秒後 |
本数より驚いたのは、本体の大きさです。送った文は86バイトなのに、要求は26,174バイトありました。中身を分けてみると、tools に組み込みツールが39個入っていて、その定義だけで26,001バイト。要求のほぼ全部がツールの説明書だったりします。
並んでいたのは、ナレッジベースの検索、メモリの読み書き、ノート、スキル、タスク、自動実行の登録、カレンダーの予定、時刻の計算といった、Open WebUI自身の機能を呼ぶためのツールです。ナレッジベースもカレンダーも何も登録していない、まっさらな状態でも39個すべてが毎回付いてきます。
環境変数で止めたつもりが、止まらなかった
題名・タグ・続きの質問の3本は、環境変数 ENABLE_TITLE_GENERATION / ENABLE_TAGS_GENERATION / ENABLE_FOLLOW_UP_GENERATION で止められます。そこで3つとも false にして起動し直し、別の会話で1通送りました。結果は、4本のまま。題名もタグも、何事もなかったように付きました。
理由は、初回起動のログにあった Seeded 368 new config defaults です。Open WebUIは最初の起動で設定の既定値を368件データベースに書き込み、2回目以降はそちらを優先します。open_webui/models/config.py のコメントにも Existing DB values take precedence over defaults. とありました。理屈はそうなんですが、Dockerの -e で設定を足していく運用に慣れていると、ここはまず引っかかると思います。
# B: 3つの生成を false にして起動し直す → 4本のまま
$ open-webui serve   (ENABLE_TITLE_GENERATION=false ENABLE_TAGS_GENERATION=false ENABLE_FOLLOW_UP_GENERATION=false)
n=5 task=title bytes=1253 / n=6 task=chat bytes=26172 / n=7 task=follow_ups bytes=1256 / n=8 task=tags bytes=1002

# C: さらに ENABLE_PERSISTENT_CONFIG=false → 本体だけになる
n=9 task=chat bytes=26168

# D: さらに ENABLE_TOOL_SEARCH=true → 本体が3分の1近くに
n=10 task=chat bytes=9212 (system 4,822バイト + tools 13個 4,091バイト)
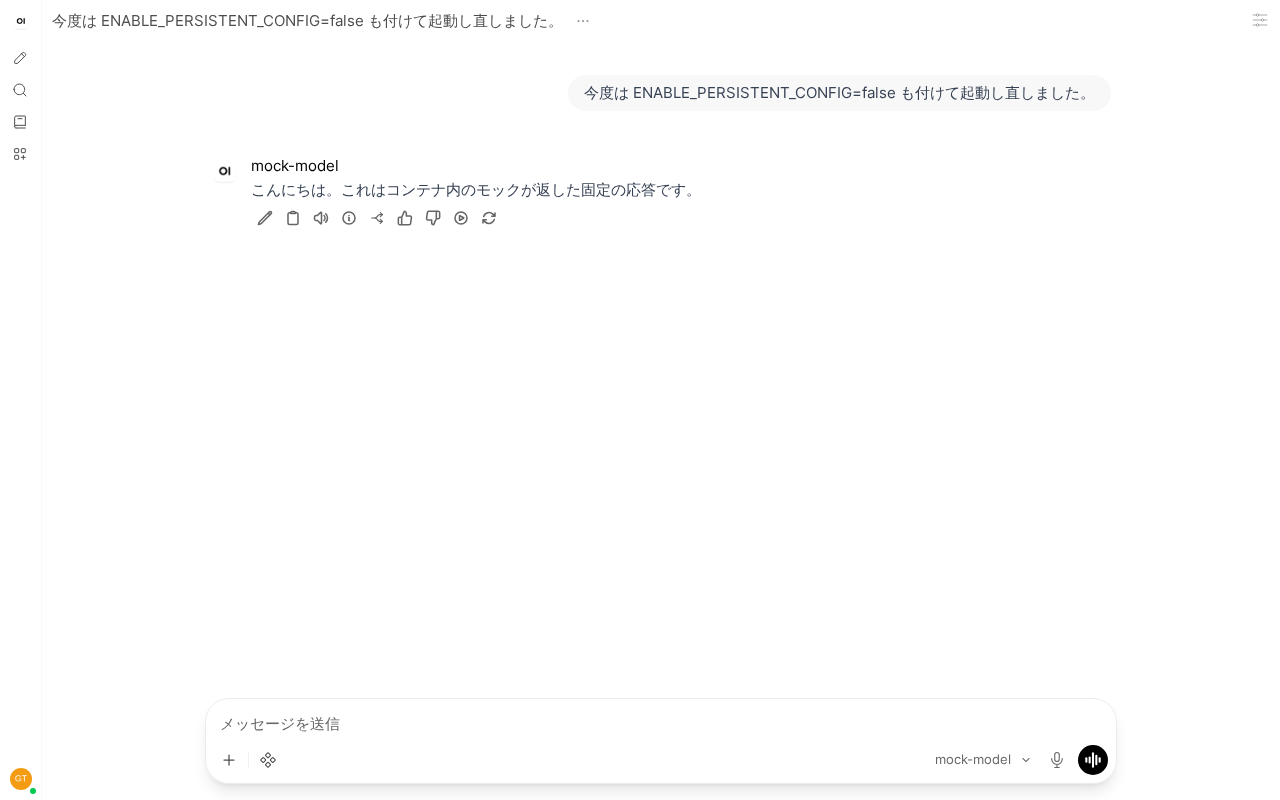
ENABLE_PERSISTENT_CONFIG=false を足すと、ようやく環境変数が効き、要求は本体の1本だけになりました。題名は送った文がそのまま入り、関連質問も出ません。
本体に付いてくる39個のツールは、ENABLE_TOOL_SEARCH=true にすると減りました。定義が短い12個と、残りを探すための search_tools の計13個だけを送り、それ以外はsystemメッセージに名前の一覧として載せる方式です。本体は26,168バイトから9,212バイトになりました。
| 起動のしかた | 1通あたりの要求 | 本体の大きさ |
|---|---|---|
| A 既定のまま | 4本(合計29,691バイト) | 26,174バイト(ツール39個) |
| B 起動後に3つの生成を false | 4本のまま | 26,172バイト |
| C Bに ENABLE_PERSISTENT_CONFIG=false | 1本 | 26,168バイト(ツール39個) |
| D Cに ENABLE_TOOL_SEARCH=true | 1本 | 9,212バイト(ツール13個) |
なお、2回目以降の起動は初回のようなダウンロードが無く、再起動を指示してから11〜14秒ほどで応答が返りました。起動していたプロセスのメモリは、1通目を送った後で約1.3GB(RSS)です。
試してみての所感
フレームワークは目的ではなく道具、とよく言っています。Open WebUIもそれと同じで、既定値は「全部入り」に倒してあり、どれを削ってどれを残すかを決めるのは入れる側の仕事なんですよね。今回の数字で言えば、題名・タグ・続きの質問の3本は会話の見通しを良くする分の追加費用で、39個のツールは「Open WebUIの機能をLLMから呼べる」分の固定費です。
自分が社内に入れるなら、次の順で決めると思います。
- 従量課金のAPIにつなぐなら、まずツール検索を有効にするかを決める。1通あたり17KB近く送る量が減るのは、利用者が増えるほど効いてきます
- 題名とタグは、どちらか1つ残せば十分な気がしています。続きの質問は、使われ方を見てからでも遅くありません
- 設定は環境変数より管理画面で変える前提にする。環境変数で管理したいなら
ENABLE_PERSISTENT_CONFIG=falseですが、そのとき管理画面で変えた値がどう扱われるかは、今回確かめていません
逆に、ローカルのモデルにつなぐなら、ツールの分はお金ではなく文脈の長さと速さの問題になります。小さなモデルで39個の定義を毎回読ませるのが割に合うかは、ここは好みが分かれるところですが、私は様子見です。
インストールの7.6GBと、初回起動の889MBのダウンロードは、検証環境のディスクを見積もるときにそのまま使える数字でした。次はCPU版のtorchを先に入れる手順で、どこまで縮むかを測ってみるつもりです。